
- Přehledy IS
- APS (20)
- BPM - procesní řízení (22)
- Cloud computing (IaaS) (10)
- Cloud computing (SaaS) (36)
- CRM (53)
- DMS/ECM - správa dokumentů (20)
- EAM (17)
- Ekonomické systémy (69)
- ERP (77)
- HRM (28)
- ITSM (6)
- MES (31)
- Řízení výroby (38)
- WMS (31)
- Dodavatelé IT služeb a řešení
- Datová centra (25)
- Dodavatelé CAD/CAM/PLM/BIM... (40)
- Dodavatelé CRM (33)
- Dodavatelé DW-BI (50)
- Dodavatelé ERP (71)
- Informační bezpečnost (50)
- IT řešení pro logistiku (45)
- IT řešení pro stavebnictví (25)
- Řešení pro veřejný a státní sektor (27)
Hlavní partner sekce
Tematické sekce
 ERP systémy CRM systémy Plánování a řízení výroby AI a Business Intelligence DMS/ECM - Správa dokumentů HRM/HCM - Řízení lidských zdrojů EAM/CMMS - Správa majetku a údržby Účetní a ekonomické systémy ITSM (ITIL) - Řízení IT Cloud a virtualizace IT IT Security Logistika, řízení skladů, WMS IT právo GIS - geografické informační systémy Projektové řízení Trendy ICT E-commerce B2B/B2C CAD/CAM/CAE/PLM/3D tisk
Branžové sekce
 | |
| Přihlaste se k odběru newsletteru SystemNEWS, který každý týden přináší výběr článků z oblasti podnikové informatiky | |
 | |
Partneři webu
IT SYSTEMS 9/2026 , AI a Business Intelligence


Čistá data umělé inteligenci nestačí
„AI readiness“ není status, ale provozní disciplína
Jessie Smith
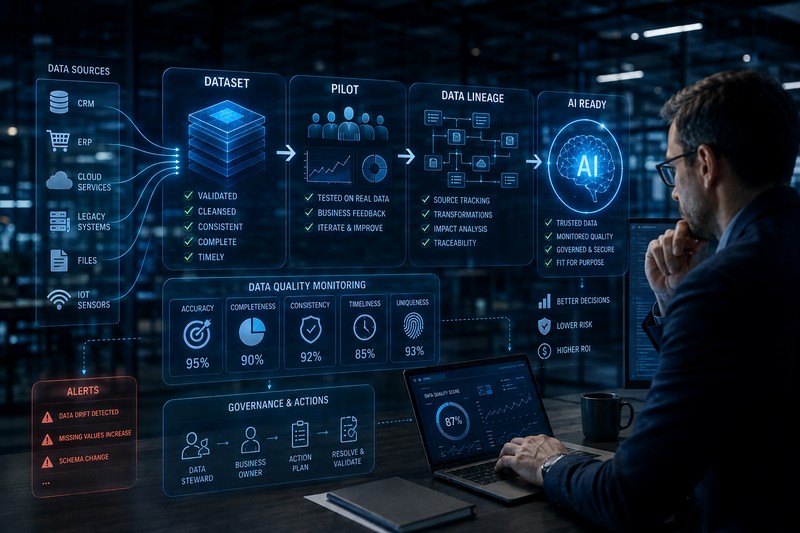 O tom, že kvalita dat je pro úspěch AI kritická, dnes nikdo nepochybuje. Některé firmy ovšem předpokládají, že je to úkol konečný. Uklidíme si v datech, odškrtneme položku a můžeme stavět. Jenže implementace AI v podnikovém měřítku vyžaduje změnu chápání. Nestačí hlídat jen samotnou kvalitu dat, je třeba definovat, co pro dané využití AI znamená „důvěryhodná data“. V dynamickém ostrém provozu mohou i jednou čistá data ztratit svou relevanci. „AI readiness“ tak spočívá ve schopnosti průběžně vyhodnocovat kvalitu a důvěryhodnost dat pro dané použití, znalosti jejich původu (lineage) a vlivu na navazující procesy a také stanovení odpovědnosti a postupů pro situace, kdy už požadavky nesplňují.
Představte si, že máte dva systémy, které sledují aktivitu zákazníků. Jeden ji počítá jako nákup za posledních třicet dní, druhý za dvanáct měsíců. Oba poskytují čistá data a správný výsledek. Jenže podle jiné definice. Když se ale spojí a kontext se cestou ztratí, vznikne nespolehlivý vstup, přestože ani jeden zdroj neobsahuje zjevnou chybu. Analytik by si toho nejspíš všiml, AI model rozdíl ve významu vnímat nemusí. Přesně tady začíná rozdíl mezi daty čistými a důvěryhodnými. Nestačí totiž jenom vědět, že pole prošlo validací nebo že se data změnila. Potřebujete vědět, které navazující modely, agendy nebo aplikace to ovlivňuje, kdo to má posoudit a zda má systém mezitím běžet dál.
AI readiness spočívá ve schopnosti průběžně vyhodnocovat kvalitu a důvěryhodnost dat.
Úspěšný pilot dokáže skutečný problém schovat
Záludné je, že tento problém s daty v pilotním provozu nemusíte odhalit. Pilot totiž běží v prostředí, kde projektový tým zná všechny zdroje, inženýři znají jejich zvláštnosti a doménový expert je na dosah. Když model dodá divný výsledek, všimnete si ho dřív, než se dostane dál. Pro ověření use casu jsou to ideální podmínky, zároveň ale maskují předpoklady o datech, které v produkčním měřítku neudržíte.
Při ostrém nasazení začne AI číst data z akvizic, z legacy aplikací, z okrajových systémů a z procesů, které vznikaly podle jiných konvencí a často pro odlišné účely. Objevují se duplicity, hodnoty jsou vyplněné podle různých definic, povinná pole projdou validací, protože do nich někdo zapsal „neuvedeno“. Data přitom nejsou zjevně rozbitá. Dokážou však změnit závěr, ke kterému AI model dojde, přestože se sám model nezměnil. Změnilo se to, co do něj teče: přestal platit předpoklad, že data budou stejně spolehlivá jako při pilotu.
Týmy pak mohou ladit model, i když skutečná příčina sedí o patro výš, v datech. Nasazení se odsune a důvěra v celý AI projekt klesne, byť model fungoval přesně dle zadání. Konzistence, která umožnila pilot dotáhnout, přitom nemusela být vlastností dat, ale jen vlastností jeho rozsahu. Proto než pilot rozšíříte, otestujte jeho předpoklady na autentických produkčních datech.
Než rozšíříte pilotní projekt, otestujte jeho předpoklady na autentických produkčních datech.
Čistá data a vhodná data nejsou totéž
Datová kvalita a vhodnost pro daný účel spolu souvisejí, zaměnitelné ale nejsou. Dataset může projít definovanými kontrolami, a přesto být pro danou AI aplikaci k ničemu, protože jeho význam je víceznačný, aktuálnost nedostatečná nebo původ nejasný. Například jako v situaci z úvodu.
Podobně funguje aktuálnost. Rizikové skóre mohlo být v okamžiku výpočtu správné a pořád je kompletní, ve správném formátu a vnitřně konzistentní. Pokud se ale neaktualizovalo v intervalu, který daný use case vyžaduje, zhoršila se jeho použitelnost, byť technická „čistota“ zůstala stejná. Jako přesná mapa stará deset let. Nakreslená je bezchybně, jen podle ní dnes nedojedete.
Technická validace i byznysová pravidla ověřují data proti definovaným očekáváním. AI tyto kontroly kvality nenahrazuje, ale zvyšuje důležitost okolního kontextu a průběžných důkazů: Co pole znamená pro dané použití? Jak aktuální musí být? Odkud pochází? Jakými transformacemi data prošla? Jaké důkazy o kvalitě jsou k dispozici a splňují prahové hodnoty požadované pro AI systém, který je využívá? Požadavky se liší případ od případu. Data, která stačí na čtvrtletní report, nemusí stačit systému rozhodujícímu průběžně.
Běžně se pak stává, že i ve firmách, které pečlivě řídí kvalitu svých dat, produkuje AI výsledky, jimž lidé nevěří. Nikdo totiž nedefinoval dodatečné podmínky, které konkrétní nasazení AI vyžaduje. U důležitých AI aplikací je navíc nutné je pojmenovat explicitně. Prahová hodnota nastavená kdysi kvůli reportingu připravenost na AI neznamená.
Detekce není řízení
Definovat podmínky je ale jen půlka práce, protože ty se po nasazení mění dál. Detekce vám řekne jen to, že se něco změnilo nebo neodpovídá očekáváním, ale neurčí, jestli ta změna dělá data pro danou aplikaci nevhodnými, kam až se problém rozšířil a co se má dít, než se vyřeší. Funguje jako hlásič kouře, který ví, že hoří, ale neřekne co a kdo má rozhodnout o evakuaci.
Změna v jednom zdroji má navíc pokaždé jiný dopad. Záleží na tom, které datové sady, modely, agenty a aplikace na něm závisí. Když máte kompletní datovou genealogii (data lineage) víte, od jakého zdroje data tečou, přes jaké transformace a které modely, reporty nebo datasety na nich závisí, takže dokážete říct, co všechno mohlo být zasažené. Právě tahle dohledatelnost mění data lineage z dokumentace pro auditora v provozní nástroj. Bez ní je detekce rychlá, ale diagnóza pomalá.
Opakovaně vídám, že anomálii firma pozná během několika minut, ale pak stráví zbytek týdne sháněním lidí, kteří vědí, odkud ten datový přítok pochází a kdo ho smí zastavit. Je proto lepší ruční schvalování přítoků v tabulkách nahradit automatizovanou validací kvality, monitoringem, genealogií a jasně přiřazenou odpovědností. To firmu posouvá od detekce k řízení.
Když za data odpovídají všichni, neodpovídá za ně nikdo.
Účinná reakce potřebuje čtyři věci: kontext, co všechno je zasažené, jmenovitého vlastníka s pravomocí rozhodnout, vědomé rozhodnutí, jestli může systém běžet dál, a definovanou cestu k nápravě nebo k bezpečnému opětovnému použití dat. Rutinní případy jde automatizovat. U rizikovějších má odpovědnost zůstat výslovně na člověku, obzvlášť tam, kde AI ovlivňuje finanční nebo regulatorní výsledky.
Když tahle disciplína chybí, firma skončí v jedné ze dvou pastí. Buď se ruční kontrola stane úzkým hrdlem, které sebere automatizaci většinu přínosu, nebo AI běží dál s mírou datového rizika, kterou nikdo výslovně nevyhodnotil a nepřijal. Druhá varianta je horší, protože není vidět. Pod tím vším navíc leží problém, který se technologií nevyřeší: Když za data odpovídají všichni, neodpovídá za ně nikdo. A věta „to má na starosti IT“ v praxi znamená, že o vhodnosti dat pro byznys rozhoduje někdo, kdo k tomu nemá dost kontextu.
Začněte jedním use casem
Různé AI aplikace snesou různou míru zastaralosti, nejednoznačnosti a neúplnosti. Jedna univerzální laťka připravenosti, která by platila pro všechny AI use casy, proto neexistuje. Místo toho se vyplatí umět pro konkrétní použití definovat, co znamená důvěryhodné, poznat, kdy tyto podmínky přestaly platit, chápat důsledky té změny a mít připravenou reakci.
Vyberte si jeden use case s měřitelným byznysovým dopadem a jděte od něj pozpátku po cestě dat.
Když se mě někdo ptá, kde začít, odpovídám vždycky stejně. Vyberte si jeden use case s měřitelným byznysovým dopadem a jděte od něj pozpátku. Identifikujte data, která můžou výsledek zásadně ovlivnit. Definujte podmínky, za kterých jsou pro tohle použití dost důvěryhodná. Určete jasnou zodpovědnost za jejich kvalitu a použitelnost. A rozhodněte předem, jak se má systém zachovat, když přestanou platit. Může například běžet dál v definovaných mezích, sáhnout po náhradním zdroji, eskalovat na člověka, nebo se zastavit, dokud se problém nevyřeší.
Až se to osvědčí u prvního use case, můžete stejně postupovat k dalším. Být „AI ready“ je totiž provozní disciplína, ne status, který firma jednou získá a má ho už navždy. Data, systémy, které je konzumují, i aplikace na obojím postavené se totiž dál mění. Připravenost na AI se pozná až podle toho, co firma udělá ve chvíli, kdy jí data přestanou stačit.
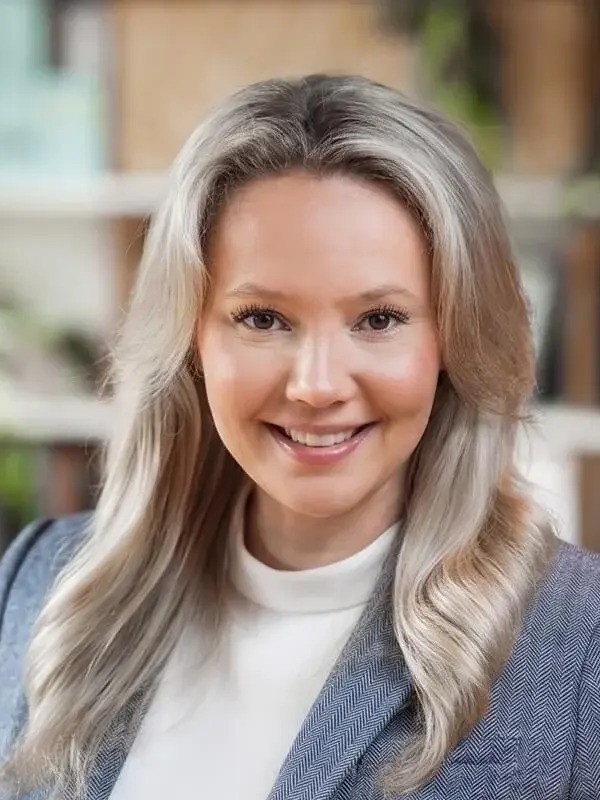 |
Jessie Smith Autorka článku je Chief Product Officer společnosti Ataccama. |
Chcete získat časopis IT Systems s tímto a mnoha dalšími články z oblasti informačních systémů a řízení podnikové informatiky? Objednejte si předplatné nebo konkrétní vydání časopisu IT Systems z našeho archivu.




 říjen - 2026  | ||||||
| Po | Út | St | Čt | Pá | So | Ne |
| 1 | 2 | 3 | 4 | |||
| 5 | 6 | 7 | 8 | 9 | 10 | 11 |
| 12 | 13 | 14 | 15 | 16 | 17 | 18 |
| 19 | 20 | 21 | 22 | 23 | 24 | 25 |
| 26 | 27 | 28 | 29 | 30 | 31 | 1 |
| 2 | 3 | 4 | 5 | 6 | 7 | 8 |


